Respuesta corta
Optical Character Recognition (OCR), o reconocimiento óptico de caracteres, identifica texto en imágenes y documentos escaneados. Si una factura llega como fotografía, OCR puede leer el número y el importe. Eso no demuestra que el número pertenezca al proveedor correcto, que el importe coincida con una orden de compra o que deba pagarse. Leer y decidir son etapas distintas.
En una fraseOCR reconoce texto en un documento; la inteligencia documental combina extracción, estructura, validación y acciones sobre esa información.
OCR: convertir una imagen en texto utilizable
Las herramientas actuales no tienen una frontera rígida: algunas funciones llamadas «OCR» también detectan layout, tablas o pares clave-valor. Por eso conviene comparar la capacidad concreta y no sólo el nombre comercial. La pregunta operativa es qué información se extrae, cómo se valida y qué pasa después.
Del documento a la decisión
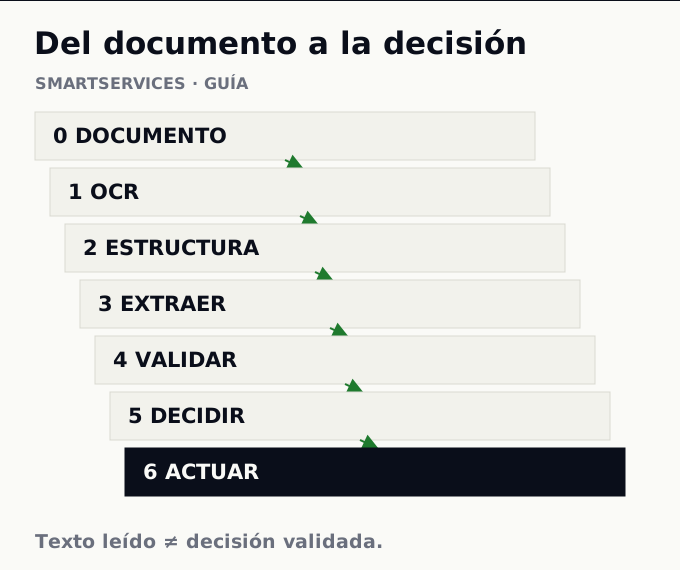
Un flujo documental puede avanzar por siete etapas: documento → texto → estructura → extracción → validación → decisión → acción. El texto puede decir «Factura 381». La estructura identifica que está en el encabezado. La extracción lo guarda como número de factura. La validación comprueba proveedor, orden, impuestos e importes. Una regla o persona decide si se acepta; otro sistema registra el resultado.
Este «document-to-decision pipeline» es un modelo explicativo, no un estándar formal. Ayuda a señalar dónde falla un proyecto. Una tasa alta de lectura de caracteres no sirve si la decisión final se toma con el proveedor equivocado.
Qué agregan la estructura y la clasificación
La extracción de layout identifica párrafos, celdas, tablas y su posición. La clasificación distingue factura, orden de compra, contrato o reclamo. La extracción de entidades busca campos útiles: fecha, CUIT, número, moneda, importe. Un campo puede faltar, estar repetido o aparecer en una nota. El sistema debe conservar evidencia de dónde lo encontró.
Un modelo de lenguaje puede ayudar a interpretar texto libre o formatos variables. No debería inventar un dato ausente para completar una tabla. En documentos con consecuencias financieras o legales, un valor extraído necesita validación con reglas, sistemas maestros y, donde corresponda, revisión humana.
La factura que parece correcta
Ejemplo hipotético: OCR lee «Factura 381, $120.000». El sistema encuentra al proveedor, pero la orden autoriza $102.000. Un flujo serio no marca «éxito» porque leyó el texto. Detecta la diferencia, consulta tolerancias y envía una excepción. Si la factura duplica otra, debe detener el registro. Si la orden no existe, debe pedir información. La acción final se basa en el proceso, no en la confianza del OCR.
El mismo principio aplica a reclamos, contratos y formularios. Un contrato puede incluir una fecha en una cláusula y otra en una firma; elegir la primera que aparece es una mala regla. Un email puede contener una solicitud y una cita del mensaje anterior; ambas no tienen la misma intención.
Qué medir y qué no prometer
Medí por separado legibilidad, extracción de campos, validación, intervención humana y resultado operativo. La precisión de caracteres no representa la calidad de un proceso completo. También importan el tiempo por documento, el costo de revisar excepciones y la trazabilidad. Probá con documentos nuevos, no sólo con los ejemplos usados para configurar el sistema.
No conviene automatizar de punta a punta un documento con campos críticos ambiguos, reglas cambiantes o fuentes maestras inconsistentes. A veces el primer trabajo es normalizar proveedores y conectar sistemas. La integración permite verificar lo extraído frente a la información operativa.
Preguntas frecuentes
¿OCR entiende el significado de una factura?
OCR lee texto. Algunas plataformas añaden extracción y clasificación, pero la validación del significado de negocio requiere reglas, datos y contexto.
¿La inteligencia documental siempre usa IA generativa?
No. Puede combinar OCR, modelos de clasificación, plantillas, reglas e intervención humana. El modelo depende del documento y del riesgo.
¿Qué pasa si el PDF ya contiene texto?
Quizá no necesite OCR, pero sí estructura, extracción y validación. Un PDF digital no garantiza datos listos para operar.
¿Cómo se tratan los documentos ilegibles?
Con una ruta explícita: pedir mejor copia, derivar a revisión o detener la acción. Completar valores por conjetura no es un control.
Aplicación empresarial
Smartservices aborda la inteligencia documental como parte de un proceso: entrada, datos confiables, validación, excepción y acción. Puede combinarse con automatización, pero la meta es una decisión correcta y rastreable, no sólo producir texto.