Respuesta corta
Human-in-the-Loop (HITL), o «humano en el circuito», significa diseñar puntos concretos donde una persona revisa, aprueba, corrige o completa el trabajo de un sistema. No significa que alguien deba mirar cada paso. Tampoco significa dejar una bandeja de casos sin dueño y llamarla «supervisión». La intervención tiene un motivo, una persona responsable y una acción posible.
En una fraseHuman-in-the-Loop incorpora revisión, aprobación o corrección humana en puntos definidos de un sistema automatizado o de IA.
Qué significa Human-in-the-Loop
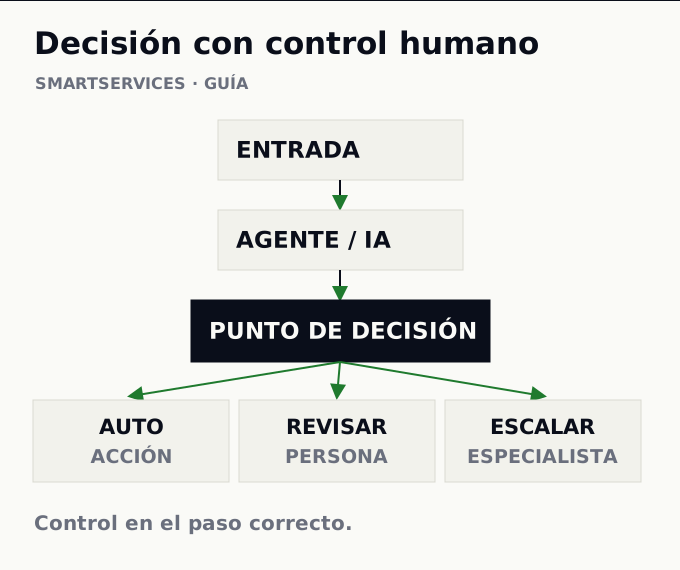
Un sistema puede resolver automáticamente lo que cumple reglas claras y enviar a una persona lo que requiere criterio, datos faltantes o una autorización. El humano no tiene que estar en todos los pasos. Tiene que estar en el paso correcto.
Auto, Review, Escalate: tres salidas de una decisión
Usamos tres rutas como modelo operativo, no como estándar universal. Auto: la tarea cumple condiciones definidas y puede ejecutarse. Review: la salida está lista, pero requiere aprobación o corrección antes de producir efecto. Escalate: faltan datos, el caso sale del alcance o la incertidumbre exige un especialista. Cada ruta necesita límites y un registro de quién decidió qué.
Ejemplo hipotético: un agente recibe reclamos. Puede confirmar automáticamente que una orden existe y enviar un acuse. Puede proponer una categoría para revisión cuando el texto es ambiguo. Debe escalar si el reclamo exige una excepción a la política o hay riesgo de una acción irreversible. Un botón «aprobar» no es control suficiente si la persona no ve evidencia y alternativas.
Antes, durante y después del circuito
La supervisión empieza antes de ejecutar: alguien define tareas permitidas, fuentes, permisos, umbrales y acciones prohibidas. Durante la ejecución, el sistema puede detenerse en un punto de revisión o pedir información. Después, las personas auditan muestras, incidentes y resultados para corregir reglas. Estas formas de control son complementarias. Una revisión posterior no protege una operación irreversible que ya se completó.
Confianza del modelo no equivale a riesgo
Una puntuación de confianza puede indicar cómo evalúa un modelo una salida bajo ciertas condiciones. No mide por sí sola el costo de equivocarse. Clasificar un correo en una carpeta y autorizar un pago tienen consecuencias distintas aun con la misma puntuación. El criterio práctico compara el costo esperado del error con el costo de revisar, pero no existe una fórmula universal que sustituya la política y el contexto.
Un umbral único también falla cuando cambian los tipos de caso. Puede haber errores raros pero graves, categorías con pocos ejemplos o datos fuera de distribución. Por eso conviene usar reglas de negocio, señales de calidad de entrada, reversibilidad y severidad, además de la confianza. Cuando falta evidencia, la ruta correcta puede ser pedir un dato, no adivinar.
Diseñar la revisión para que sirva
- Mostrá a la persona la entrada original, la propuesta y la evidencia utilizada.
- Permití corregir, rechazar o devolver el caso; no sólo aprobar.
- Registrá la decisión y el motivo sin guardar información innecesaria.
- Medí cuántas revisiones cambian realmente el resultado y cuánto demoran.
- Usá los errores observados para ajustar límites y pruebas.
Un circuito humano mal diseñado puede ser peor que una regla simple: genera fatiga de aprobación y una falsa sensación de seguridad. Medir intervención y corrección permite saber si la revisión aporta valor.
Cuándo no dejar un proceso completamente autónomo
No hay una lista universal de procesos prohibidos. Sí hay señales claras para exigir control: consecuencias relevantes para personas, dinero o acceso; decisiones difíciles de revertir; datos sensibles; requisitos de autorización; o errores que el sistema no detecta bien. El diseño debe establecer quién responde por la decisión final y cómo detener o revertir una acción cuando sea posible. El marco de riesgo de NIST insiste en definir responsabilidades humanas según el contexto.
Preguntas frecuentes
¿HITL exige revisar el 100% de los casos?
No. Puede aplicarse a excepciones, muestras, acciones de alto impacto o un período inicial de prueba. La cobertura debe responder al riesgo, no a una consigna.
¿Si hay una persona el sistema ya es seguro?
No. La persona necesita tiempo, información y facultad real para cambiar la salida. Una aprobación automática por cansancio no es una barrera efectiva.
¿Qué pasa si nadie responde a una escalación?
El flujo necesita un estado seguro, responsable asignado y plazo. No debe ejecutar por defecto una acción no autorizada.
¿HITL sólo aplica a agentes de IA?
No. También puede controlar automatizaciones determinísticas, por ejemplo una excepción a una regla de pagos.
Aplicación empresarial
En Smartservices separamos pasos automáticos, revisiones y escalaciones al diseñar un agente de IA o una automatización. La intervención humana se define antes de publicar el flujo, no después del primer incidente.