Respuesta corta
Un agente de IA puede responder con claridad y fallar en la tarea. Puede decir «orden registrada» cuando la herramienta devolvió un error, o entregar un resumen útil sin actualizar el sistema que debía actualizar. Por eso la métrica principal no debería ser cuántos mensajes generó ni cuántas respuestas parecieron buenas. Debe ser qué trabajo terminó correctamente, con qué intervención, costo y tiempo.
En una fraseNo existe una métrica universal para un agente: hay que medir finalización, corrección, intervención humana, costo y tiempo por tarea.
Medir trabajo, no sólo conversaciones
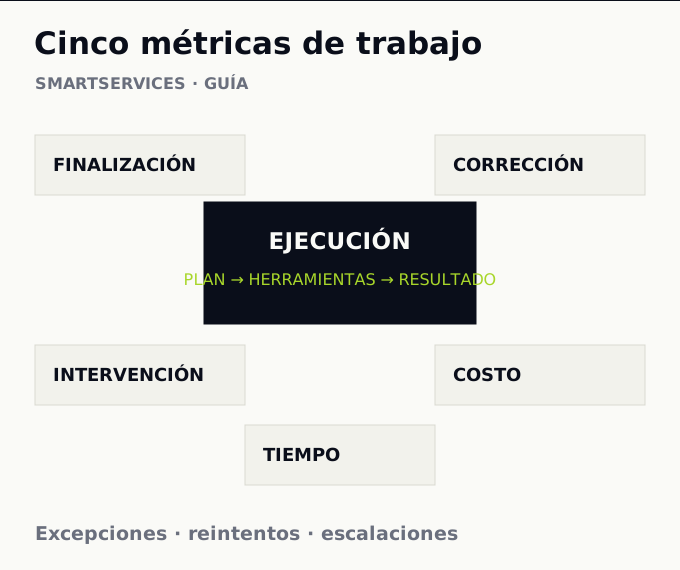
No existe una única métrica universal para saber si un agente funciona. Para explicarlo de forma operativa usamos cinco medidas de trabajo: finalización, corrección, intervención, costo y tiempo. Es un marco editorial de Smartservices, no un estándar de industria. Las medidas deben definirse para cada tarea y su riesgo.
Las cinco métricas de trabajo
1. Finalización
¿Llegó la tarea a un estado final verificable? «El agente respondió» no cuenta si el objetivo era crear una orden. Definí estados: completada, incompleta, cancelada y derivada. Registrá una evidencia externa cuando sea posible, como el ID creado en el sistema destino.
2. Corrección
¿El resultado final es correcto según criterios definidos antes de la prueba? Una tarea puede quedar «completada» técnicamente y contener un importe equivocado. Medí tanto tareas correctas sobre todas las iniciadas como tareas correctas entre las completadas. Informá ambos denominadores. El falso éxito —una confirmación convincente de una acción que no ocurrió— merece seguimiento propio.
3. Intervención
¿Cuántos casos necesitaron ayuda humana? Separá aprobaciones previstas, correcciones por error y escalaciones por falta de información. Una intervención no siempre es falla: en procesos sensibles puede ser el control correcto. Medí tiempo humano y calidad de la decisión, no sólo frecuencia.
4. Costo
Incluí modelo, herramientas, infraestructura, revisión humana y reintentos. El costo por conversación puede ocultar que varias conversaciones fueron necesarias para una tarea. Una medida más útil es costo por tarea completada correctamente, con el volumen y período indicados. No reduzcas la comparación a tokens si hay procesos, personas y sistemas involucrados.
5. Tiempo
Medí desde solicitud hasta resultado útil. Separá latencia de modelo, espera de herramientas, colas y tiempo de revisión. El promedio puede esconder casos extremos; observá percentiles y compromisos operativos cuando existan. Un agente rápido que obliga a rehacer trabajo puede ser más lento para la empresa.
La segunda capa: excepciones y fallas
Las cinco medidas dicen cómo terminó el trabajo. Una capa de excepciones explica por qué falló: herramientas no disponibles, reintentos, timeouts, datos faltantes, bloqueos de política, acciones inválidas, rollback y escalaciones. Registrá cada evento con un identificador de tarea y etapa. No guardes más datos sensibles de los necesarios para diagnosticarlo.
La confiabilidad de herramientas merece atención aparte. Una respuesta del modelo puede ser impecable mientras una API devolvió un error o un webhook no llegó. Un rastro de ejecución debe unir solicitud → plan → llamadas a herramientas → acción → resultado. Tracing y logs ayudan a encontrar dónde se perdió el trabajo, pero el resultado de negocio debe verificarse en el sistema final.
Un tablero que no confunde resultados
Ejemplo hipotético, no un resultado de Smartservices: se iniciaron 100 tareas comparables. 92 terminaron con un estado «completado»; 87 fueron verificadas como correctas. Entonces la finalización es 92/100, la corrección sobre tareas iniciadas es 87/100 y la corrección entre completadas es 87/92. Las cinco completadas restantes pueden ser falsos éxitos o resultados erróneos; hay que investigarlas. Hubo 11 intervenciones humanas, 8 reintentos y 2 fallas de herramienta. Esos grupos pueden superponerse: no se suman como si fueran tareas distintas.
| Medida | Resultado | Pregunta siguiente |
|---|---|---|
| Completadas | 92/100 | ¿Qué impidió las otras 8? |
| Correctas verificadas | 87/100; 87/92 completadas | ¿Qué pasó en las 5 completadas incorrectas? |
| Intervención humana | 11 tareas | ¿Era revisión prevista o corrección? |
| Reintentos | 8 tareas | ¿Qué herramienta o dato los provocó? |
| Falla de herramienta | 2 tareas | ¿Se detectó y recuperó? |
Otro ejemplo hipotético: 95% de respuestas reciben una evaluación conversacional positiva, pero sólo 60% de las tareas terminan correctamente. No hay contradicción: la calidad de la charla y el éxito operativo miden cosas distintas. No presentar el 95% como «precisión del agente».
Evaluación antes y después de publicar
Antes de producción, armá un conjunto de tareas representativo: casos simples, ambiguos, excepciones, datos faltantes y solicitudes fuera de permiso. Definí el resultado esperado y qué evidencia lo demuestra. Probá cambios de prompt, modelo y herramientas contra el mismo conjunto, pero no entrenes o ajustes sobre el propio conjunto de evaluación. Revisá errores cualitativamente, no sólo un puntaje agregado.
En producción, monitoreá trazas y resultados, pero también cambios del entorno: nuevas políticas, documentos, APIs, usuarios y distribuciones de casos. Una evaluación que pasó el mes anterior no protege frente a una integración modificada. Controlá versiones, muestreá resultados con personas y mantené una forma de detener o revertir acciones cuando corresponda. La intervención humana debe ser parte del diseño, no una reacción improvisada.
Resultado de negocio y límites de interpretación
Si es medible, agregá una tercera capa: tiempo ahorrado, errores evitados, calidad del servicio o capacidad del equipo. Separá estos resultados de métricas del agente. Una caída en costo por tarea puede venir de menor revisión, pero también de errores no detectados. Un aumento de intervención puede ser bueno si evita acciones incorrectas. No hay un número mágico que sustituya el análisis del proceso.
Preguntas frecuentes
¿Cómo sé si un agente funciona?
Definí la tarea y una evidencia externa de finalización correcta. Medí finalización, corrección, intervención, costo y tiempo con sus denominadores y excepciones.
¿Qué es task completion rate?
Es tareas que llegan al estado definido como completado dividido por tareas iniciadas elegibles. No implica que el resultado sea correcto; medí eso aparte.
¿Cómo calculo el costo por tarea?
Sumá costos de modelo, herramientas, infraestructura y tiempo humano del período; dividí por tareas completadas correctamente si esa es la unidad de valor. Declarar el alcance evita comparaciones engañosas.
¿Una intervención humana es un error?
No necesariamente. Puede ser una aprobación requerida. Separá intervención prevista, excepción y reparación de un fallo.
¿Qué registra una traza?
La secuencia de pasos y herramientas usada por una ejecución. Ayuda a diagnosticar, pero no reemplaza comprobar el resultado en el sistema de negocio.
Cómo lo llevamos al diseño
Smartservices evalúa agentes de IA como trabajo dentro de un proceso, no como conversaciones aisladas. El método define resultado, controles y medición antes de expandir la autonomía. Este marco de cinco medidas sirve para discutir operación; no se presenta como estándar universal ni como una promesa de desempeño.