Respuesta corta
Retrieval-Augmented Generation (RAG) combina búsqueda de información y generación. Ante una pregunta, el sistema recupera fragmentos que podrían responderla, los coloca en el contexto de un modelo de lenguaje y genera una respuesta. El modelo no queda entrenado automáticamente con esos documentos. Esa diferencia importa: actualizar un documento puede cambiar la evidencia disponible sin volver a entrenar el modelo.
En una fraseRetrieval-Augmented Generation (RAG) combina recuperación de información relevante con generación de respuestas a partir de ese contexto.
Qué es RAG, sin confundirlo con entrenamiento
La idea es simple: buscar → seleccionar evidencia → dar contexto → responder. RAG no hace que un modelo sepa todo. Le permite consultar información antes de responder. Su valor depende tanto de la recuperación como de la generación.
La ruta de una pregunta
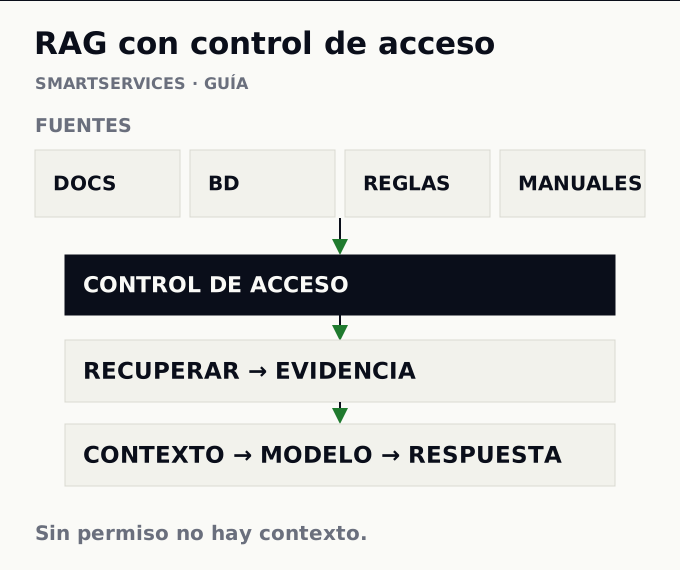
- La persona pregunta, por ejemplo, «¿qué exige nuestra política de devoluciones?».
- El sistema verifica identidad y permisos.
- Busca en documentos, bases de conocimiento u otras fuentes autorizadas.
- Selecciona pasajes pertinentes y, si hace falta, los reordena.
- Entrega esos pasajes al modelo como contexto, con instrucciones de uso.
- El modelo responde y puede mostrar referencias a las fuentes consultadas.
Ese orden no garantiza verdad. Un resultado recuperado puede ser antiguo, ambiguo o estar fuera de contexto. Una respuesta fluida puede citar un párrafo que no respalda la conclusión. Por eso conviene evaluar recuperación, fidelidad de la respuesta y posibilidad de decir «no encuentro evidencia suficiente» por separado.
Cómo se prepara la información
Muchos sistemas dividen documentos en chunks o fragmentos para buscarlos con precisión. Un fragmento demasiado pequeño puede perder el contexto de una excepción; uno enorme puede desplazar evidencia más útil. Metadatos como título, versión, fecha, idioma y permisos ayudan a filtrar. La preparación de PDFs, tablas y anexos importa tanto como el algoritmo de búsqueda. Si el documento está desordenado, primero puede requerir inteligencia documental.
La recuperación puede usar palabras clave, vectores construidos a partir de embeddings o una combinación híbrida. Un embedding representa características del texto para encontrar similitud; no es una copia legible ni una garantía de sentido. El reranking reordena candidatos para intentar poner la mejor evidencia primero. Ninguna técnica elimina la necesidad de probar preguntas reales.
Permisos: la capa que no puede faltar
Un resultado relevante no debe mostrarse si la persona no tiene derecho a verlo. Los controles de acceso deben aplicarse antes de entregar contenido al modelo, no sólo ocultando una cita en la interfaz. También hay que revisar índices compartidos, cachés, logs y enlaces a archivos originales. Una política pública y un contrato confidencial pueden hablar del mismo tema; relevancia y autorización son criterios distintos.
RAG frente a fine-tuning, búsqueda y contexto largo
| Enfoque | Qué hace | Qué no resuelve por sí solo |
|---|---|---|
| RAG | Recupera evidencia para una respuesta. | Calidad, permisos o actualidad deficientes. |
| Fine-tuning | Ajusta el comportamiento de un modelo con ejemplos. | Acceso fiable a documentos cambiantes. |
| Búsqueda | Devuelve resultados para que una persona los lea. | Una síntesis con límites explícitos. |
| Contexto largo | Permite incluir más material en la solicitud. | Elegir qué material corresponde y quién puede verlo. |
Estos enfoques se pueden combinar. RAG no es sinónimo de base vectorial: una búsqueda por palabras bien diseñada puede servir mejor en ciertas consultas. Tampoco es un reemplazo de un sistema transaccional. Si la pregunta pide «¿cuánto stock hay ahora?», la respuesta quizá deba venir de una API operativa, no de un PDF indexado ayer.
Cuándo sirve y cuándo no
RAG ayuda cuando una respuesta necesita consultar políticas, manuales, documentación técnica o conocimiento que cambia. Tiene sentido cuando las fuentes tienen dueño, versión y permisos, y cuando se puede comprobar la respuesta. Aporta menos si hay una única regla corta, datos transaccionales que requieren exactitud en tiempo real o documentos contradictorios sin gobierno. En esos casos, primero hay que arreglar la fuente o la integración.
Preguntas frecuentes
¿RAG entrena al modelo con mis documentos?
No por sí mismo. Los documentos recuperados se usan como contexto para una respuesta. Entrenar o ajustar el modelo es otra operación.
¿RAG elimina las alucinaciones?
No. Puede mejorar el anclaje en fuentes, pero el sistema aún puede recuperar mal o generar una conclusión que la fuente no sostiene.
¿Necesito una base vectorial?
No siempre. La búsqueda por palabras, filtros y recuperación híbrida pueden ser apropiadas según el corpus y las preguntas.
¿Puede respetar permisos por usuario?
Sí, si la arquitectura filtra evidencia con la identidad y autorización correctas en cada consulta. Indexar todo y ocultar resultados sólo en pantalla no basta.
¿RAG funciona con PDFs?
Sí, después de extraer y estructurar contenido usable. Un PDF escaneado, con tablas complejas o versiones mezcladas necesita preparación adicional.
Aplicación en Smartservices
Cuando un proceso necesita respuestas basadas en información propia, Smartservices evalúa fuentes, permisos, recuperación y revisión antes de elegir un modelo. Puede ser parte de una solución de inteligencia documental, de IA privada o de agentes. RAG no se presenta como producto independiente si el problema necesita otra arquitectura.